가상 응답자 결과표는 한 덩어리로 믿거나 버릴 대상이 아닙니다. 칸마다 믿을 수 있는 정도가 다릅니다.
후보 간 순서와 집단 간 방향은 참고할 만합니다. 다만 집단 사이 차이의 크기는 부풀려질 수 있습니다.
개인 예측과 절대 수치(몇 %가 산다)는 가상 응답만으로 결론 내리지 말고 사람 조사로 확인하세요.
결과표를 받았는데, 어디까지 믿어야 할까
가상 응답자 결과를 처음 받아 든 상품기획자나 마케터가 가장 먼저 묻는 것은 「이거 정확한가요?」입니다. 그런데 이 질문에는 한 번에 답하기 어렵습니다. 같은 결과표 안에서도 어떤 칸은 쓸 만하고, 어떤 칸은 그대로 쓰면 위험하기 때문입니다.
최근 나온 연구들은 이 점을 분명히 보여 줍니다. 한 연구는 가상 응답을 평가할 때 「얼마나 정확한가」를 하나의 점수로 묻지 말고, 쓰려는 용도에 필요한 성질을 갖췄는지를 따로따로 봐야 한다고 정리했습니다(D’Ecclesiis 외, 2026). 이 글은 그 생각을 결과표 읽는 순서로 옮긴 체크리스트입니다.
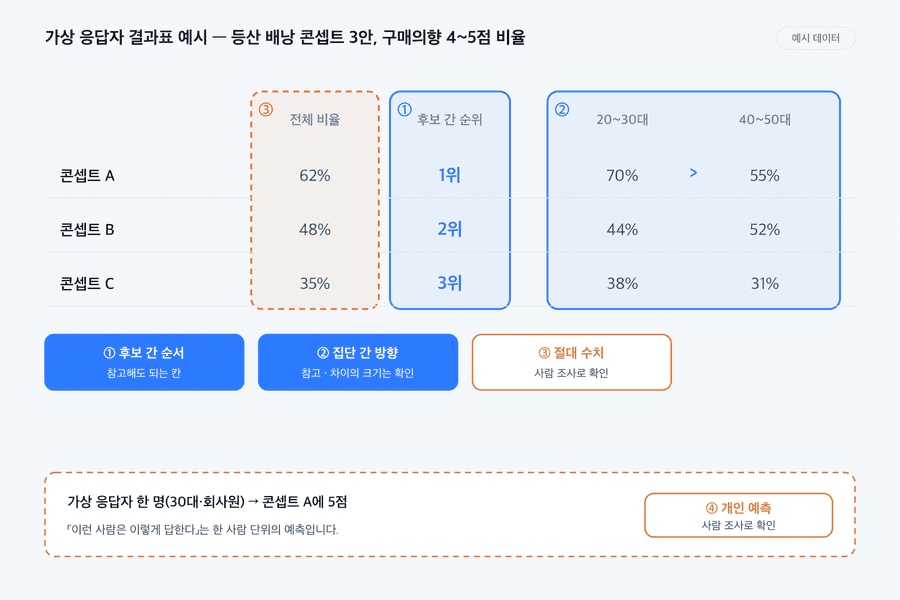
결과표의 칸마다 믿을 수 있는 정도가 다릅니다. 파란 칸은 참고하고, 주황 칸은 사람 조사로 확인합니다. (가상 품목, 예시 데이터)
칸별로 나눠 보기: 세 가지 타당성
위 연구는 가상 응답이 사람 응답을 얼마나 닮았는지를 세 갈래로 나눕니다. 결과표의 칸과 짝지으면 이렇습니다.
연구의 구분
묻는 것
결과표의 칸
예측 타당성
응답자 한 사람 한 사람의 답을 맞히는가
④ 개인 예측
분포 타당성
응답 비율·평균 같은 수준이 맞는가
③ 절대 수치
실질 타당성
집단 간 순서, 변수 사이 관계가 보존되는가
② 집단 간 방향, ① 후보 간 순서(같은 논리를 적용)
유럽연합의 정기 여론조사(Eurobarometer) 중 AI에 대한 태도 데이터에 언어모델 네 종을 적용한 결과, 응답자 한 명 단위의 일치는 불완전했습니다. 반면 일부 모델은 연령·학력 집단 사이의 순서, 국가 사이의 차이, 어떤 요인이 태도에 더 영향을 주는지의 순서를 상당 부분 보존했습니다. 연구진은 순서는 맞아도 수준은 어긋날 수 있다고 짚었습니다. 다만 결과는 모델과 문항에 따라 달랐고, 한 조사·한 주제에서 나온 결과라는 한계도 함께 밝혔습니다.
믿을 칸 ① 후보 간 순서
콘셉트 A·B·C 가운데 어느 쪽 반응이 더 좋은지, 즉 순위는 가상 응답자 결과에서 먼저 볼 칸입니다. 연구가 직접 시험한 것은 집단 간 순서지만, 같은 응답자 그룹에 조건만 바꿔 묻는 비교에도 같은 논리를 적용해 볼 수 있습니다. 응답자 구성에서 오는 치우침이 후보 모두에 비슷하게 걸린다면, 수준이 어긋나도 순서는 남을 수 있습니다. 다만 문구에 따라 치우침이 후보마다 다르게 걸릴 수도 있으니, 아래 체크리스트의 「조건을 바꿔 다시 묻기」로 확인합니다.
이렇게 쓰세요. 후보가 많을 때 아래쪽 후보를 먼저 덜어 내고, 위쪽 두세 안을 사람 조사에 올립니다. 1위와 2위의 차이가 작다면 순위를 정하지 말고 「둘 다 사람 조사로」 보냅니다.
믿을 칸 ② 집단 간 방향
「20~30대에서 A 반응이 더 높다」 「이 나라에서 가격 반응이 더 민감하다」처럼 집단 사이의 방향도 참고할 만한 칸입니다. 위 연구에서도 집단 간 순서와 국가 간 차이는 상당 부분 보존됐습니다.
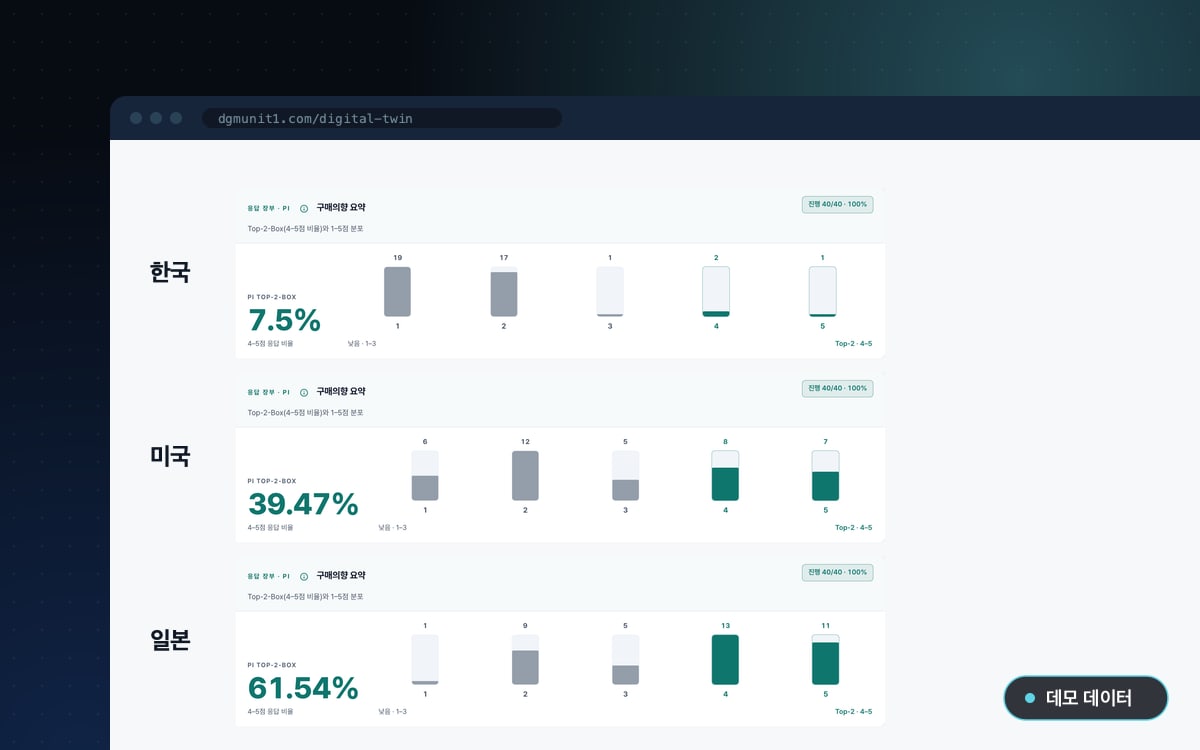
주의할 점은 크기입니다. 같은 연구는 집단 사이 차이가 실제보다 부풀려지는 경우가 많았다고 보고합니다. 어떤 지표에서는 연령 차이는 줄고 학력 차이는 커지는 식으로, 집단마다 왜곡의 방향이 달랐습니다. 그래서 「방향」은 가설로 쓰고, 「얼마나 차이 나는가」는 사람 조사로 확인합니다. 나라별 반응 차이를 가상 응답자로 먼저 보는 방법은 해외 소비자 조사 데모에 정리했습니다.
믿지 말 칸 ③ 절대 수치 — 사람 조사로 확인
「구매의향 4~5점 62%」(위 그림의 예시 수치) 같은 절대 수치는 그대로 쓰면 안 되는 칸입니다. 가상 응답의 비율·평균은 모델과 문항에 따라 실제보다 높거나 낮게, 또는 한쪽으로 치우쳐 나올 수 있습니다. 이 숫자를 시장 규모나 판매량 추정에 넣는 것이 흔한 실수입니다.
미국 일반사회조사(GSS)와 국민건강면접조사(NHIS)의 83개 결과 변수로 시험한 다른 연구는, AI 예측은 조사를 대체하지 못하며, 실제 조사 응답과 결합해 보정하는 방식으로 쓰면 평균 추정의 효율을 높일 수 있다고 보고했습니다(Wei & Zhu, 2026). 다만 언어모델이 더해 준 이득은 과거 조사 데이터로 학습한 일반 예측 모델보다 작았습니다. 절대 수치는 사람 조사가 기준이고, 가상 응답은 거기에 덧붙는 보조 정보라는 뜻입니다.
믿지 말 칸 ④ 개인 예측과 응답 조합 — 사람 조사로 확인
「30대 회사원 가상 응답자가 A에 5점을 줬다」는 한 사람 단위의 예측입니다. 앞서 본 유럽 조사 연구에서도 응답자 한 명 단위의 일치는 불완전했습니다.
또 다른 연구는 한 사람이 낸 답 전체의 조합을 봤습니다. 문항별 비율은 그럴듯해도, 실제 응답자 각자와 닮은 가상 응답자는 부족했습니다. 미국 사회조사 두 종에서 시험한 언어모델 여섯 종 모두, 주요 실험 설정에서는 문항마다 사람의 답 분포에서 따로 뽑아 이어 붙인 단순한 방식보다도 실제 응답자를 덜 닮았고, 시험한 모든 설정에서 사람 데이터로 맞춘 통계 모델보다 덜 닮았습니다(Kumagae & Kaneko, 2026).
그래서 「이런 사람은 이렇게 답한다」는 페르소나별 해석, 여러 조건을 겹친 세그먼트 교차 분석은 결론이 아니라 확인할 가설 목록으로만 씁니다.
결과표를 받았을 때 체크리스트
결과표를 받으면 위에서부터 차례로 확인해 보세요.
순위부터 본다 — 후보 간 순서가 뚜렷한가, 1·2위 차이가 작아 사실상 동률은 아닌가
방향만 적는다 — 집단 간 차이는 「어느 쪽이 더 높다」까지만 적고, 차이의 크기는 비워 둔다
절대 수치에 표시를 붙인다 — 비율·평균에는 「사람 조사 전 참고값」 표시를 붙이고, 수요·매출 추정에 넣지 않는다
개인·세그먼트 해석을 가설로 돌린다 — 페르소나별 해석, 작은 교차 집단의 결과는 사람 조사 문항 후보로 옮긴다
조건을 바꿔 다시 묻는다 — 문구·보기 순서를 바꿔도 순위와 방향이 유지되는지 본다
사람 조사와 맞출 문항을 정한다 — 가상 응답과 같은 문항을 사람 조사에 넣어, 어느 칸이 맞고 어느 칸이 어긋났는지 확인한다
마지막 항목이 빠지면 이번 결과를 얼마나 믿어야 할지 다음에도 알 수 없습니다. 디지털 트윈 실험실이 같은 조사를 실제 사람에게도 실시해 AI 조사 결과와 비교하는 절차를 설계에 넣은 것도 이 때문입니다. 가상 응답자를 써도 되는 일과 맡기면 안 되는 일 전반은 AI 설문조사, 실제 조사를 대신할 수 있을까에서 다뤘습니다.
한계
이 글의 구분은 일반적인 경향입니다. 근거로 든 연구는 모두 동료 심사 전 논문이고, 미국·유럽의 특정 조사와 특정 모델에서 나온 결과입니다. 순위와 방향도 문항과 모델에 따라 어긋날 수 있습니다. 「믿을 칸」은 사람 조사 없이 결론을 내려도 되는 칸이라는 뜻이 아니라, 사람 조사에 무엇을 올릴지 정할 때 참고해도 되는 칸이라는 뜻입니다.
가상 응답자는 사람 조사를 대신하지 않습니다. 언제, 누구에게, 무엇을 사람에게 물을지 정하는 도구로 쓸 때 쓸모가 있습니다.
다음 단계
후보가 여러 개인데 무엇을 사람 조사에 올릴지 정해야 한다면, 가상 응답자로 순위와 방향부터 확인해 보세요.
D’Ecclesiis, E. A. R., Castellacci, F., & Ahmadi, A. (2026). Validating LLM-generated synthetic survey samples: A use-dependent multi-dimensional framework for social-science applications. arXiv preprint arXiv:2611.00256. arxiv.org/abs/2611.00256
Kumagae, Y., & Kaneko, M. (2026). Silicon samples match the answers but not the respondents. arXiv preprint arXiv:2610.30900. arxiv.org/abs/2610.30900
Wei, L., & Zhu, Y. (2026). Using AI predictions to augment rather than replace surveys. arXiv preprint arXiv:2611.06743. arxiv.org/abs/2611.06743
가상 인물 데이터의 출처는 NVIDIA Nemotron-Personas(CC BY 4.0)입니다.
NEXT STEP
우리 제품 콘셉트로 직접 해 보고 싶다면
담당자가 귀사의 제품·대상 시장에 맞춘 데모 실험을 함께 설계해 드립니다. 실제 조사 전에 무엇을, 누구에게 물을지 먼저 확인해 보세요.