LLM으로 만든 가상 응답자는 질문의 표현이나 순서만 바뀌어도 다른 답을 낼 수 있습니다.
목표 점수를 미리 주지 않고 응답 일관성을 높이는 방법, 그리고 그 결과를 실제 사람 조사로 확인·보정하는 절차를 특허 출원했습니다.
이 방식은 사람 조사를 대신하지 않습니다. 실제 조사 전에 「무엇을, 누구에게 물을지」 정하는 데 씁니다.
합성 페르소나 설문, 무엇이 문제인가
합성 페르소나 설문은 대규모 언어모델(LLM)로 만든 가상 소비자에게 설문 문항을 보여 주고 답을 받는 방식입니다. 신제품 콘셉트나 가격에 대한 반응을 실제 조사 전에 가늠해 보려는 상품기획자, 마케터, 연구자들의 시도가 늘고 있습니다.
그런데 써 본 분들은 금방 한 가지 문제를 만납니다. 같은 질문을 조금 다르게 물으면 답이 달라진다는 점입니다. 「이 제품을 사고 싶으십니까?」를 「이 제품을 구매할 의향이 얼마나 있으십니까?」로 바꾸거나, 보기 순서를 1→5에서 5→1로 뒤집었을 뿐인데 점수 분포가 움직일 수 있습니다.
이 현상은 공개 연구에서도 여러 번 보고됐습니다. 인구통계 조건을 준 언어모델의 답이 실제 집단의 경향과 닮을 수 있다는 연구(Argyle 외, 2023)가 가상 응답자에 대한 기대를 키웠다면, 그 답이 얼마나 안정적인지는 별개의 문제라는 것입니다. 설문 문항의 표현과 순서를 바꿨을 때 LLM의 응답이 사람과 다른 방식으로 흔들린다는 연구(Tjuatja 외, 2024), 보기의 순서나 표시 방식에 따라 응답이 한쪽으로 쏠린다는 연구(Dominguez-Olmedo 외, 2024)가 대표적입니다.
질문 표현에 따라 답이 바뀌면, 콘셉트 A와 B의 점수 차이가 정말 콘셉트의 차이인지 문구의 차이인지 구분하기 어렵습니다. 비교가 목적인 조사에서 이 흔들림은 결과 전체를 흐립니다.
목표 점수를 정해 주면 왜 판단이 아닌가
흔들림을 줄이는 가장 쉬운 방법은 답을 미리 정해 주는 것입니다. 「이 사람은 구매의향 4점」처럼 목표 점수를 주고 그 범위 안에서 답하게 하면, 몇 번을 물어도 비슷한 답이 나옵니다.
하지만 이렇게 얻은 일관성은 가상 응답자의 판단이 아니라 주어진 값을 따른 결과입니다. 가상 소비자에게 묻는 이유는 우리가 모르는 반응을 미리 보기 위해서인데, 답을 정해 주면 우리가 이미 넣은 값을 다시 꺼내 보는 셈이 됩니다. 콘셉트를 고쳐도 점수가 그대로라면 그 조사는 아무것도 알려 주지 않습니다.
그래서 필요한 것은 두 가지 조건을 함께 만족하는 방법입니다.
정답이나 목표 점수를 주지 않는다.
그런데도 같은 응답자는 같은 기준으로 답한다.
두 가지 접근: 일관성은 높이고, 결과는 사람 조사로 확인한다
Raven’s Nest의 가상 소비자 조사 모듈인 디지털 트윈 실험실은 이 문제를 두 부분으로 나눠 다룹니다.
첫째, 목표 점수 없이 응답 일관성을 높입니다. 가상 응답자에게 정답이나 목표 점수를 주지 않으면서, 질문 표현이 달라져도 같은 응답자가 같은 기준으로 답하도록 합니다.
둘째, 사람 조사와 비교해 검증하고 보정합니다. 같은 조사를 실제 사람에게도 실시해 AI 조사 결과와 비교하고, AI 조사 결과를 얼마나 믿을 수 있는지 판정하고 보정합니다.
두 번째 부분이 중요한 이유가 있습니다. 가상 응답자의 답이 일관적이라고 해서 실제 사람의 반응과 같다는 보장은 없습니다. 일관성은 「믿을 만한 측정」의 출발점일 뿐이고, 결과를 어디까지 믿을지는 사람 조사와 맞춰 봐야 알 수 있습니다. 자세한 소개는 디지털 트윈 실험실 페이지에 있습니다.
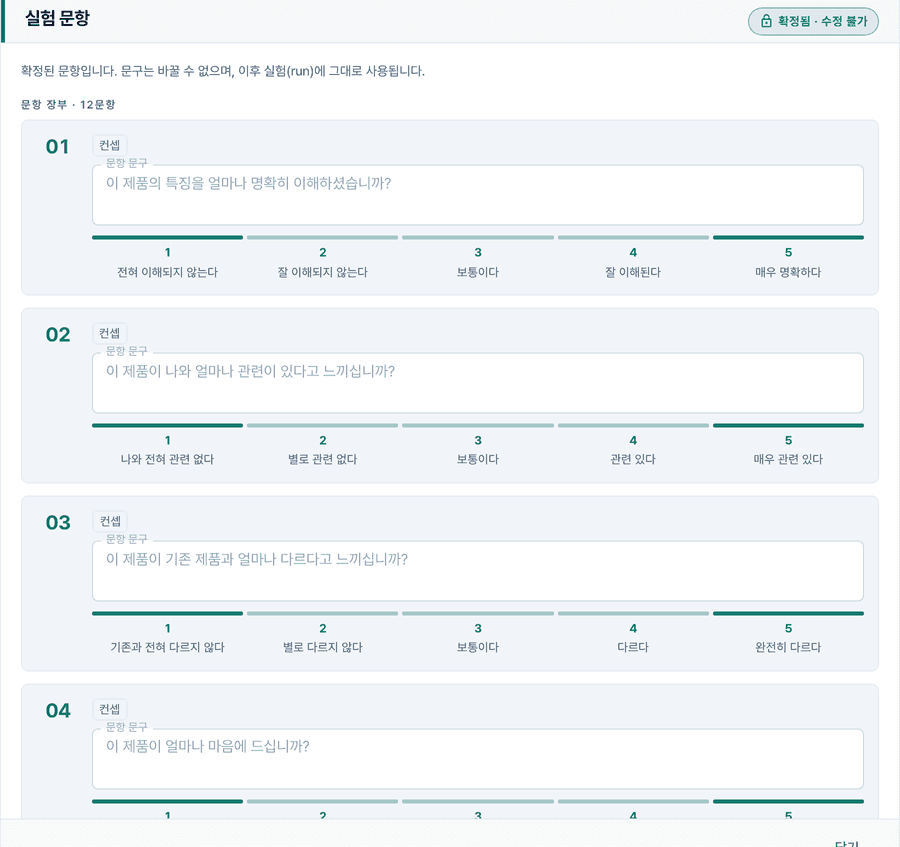
문항을 확정하면 문구를 바꿀 수 없고, 이후 실험에 같은 문항이 그대로 쓰입니다. (가상 콘셉트, 데모 데이터)
결과를 쓰기 전에 점검하는 네 가지
가상 응답자의 답을 실무에 쓰기 전에, 디지털 트윈 실험실은 아래 네 가지를 봅니다. 어떤 도구를 쓰든 합성 페르소나 설문 결과를 받았다면 함께 확인해 볼 만한 항목입니다.
표현과 순서를 바꿔 다시 묻기 — 콘셉트 비교 결과가 문구 탓인지 콘셉트 탓인지 가르려면, 같은 문항을 다르게 물어도 같은 사람의 판단이 버티는지부터 봐야 합니다.
조건 하나만 바꿔 보기 — 반대로 가격처럼 정말 중요한 조건을 바꿨는데도 답이 그대로라면 문제입니다. 어떤 조건에서도 같은 답만 내는 응답자는 일관된 것이 아니라 굳어 있는 것입니다.
실제 사람 조사와 맞춰 보기 — 위 두 가지를 통과해도 「사람과 같은가」는 별개의 질문입니다. 같은 조사를 사람에게도 해서 AI 결과를 어디까지 믿을지 정합니다.
모델이 바뀌면 다시 점검하기 — 응답을 만드는 모델이나 설정은 바뀝니다. 지난번에 통과했다고 이번에도 통과한다는 보장이 없으므로, 바뀔 때마다 같은 점검을 다시 합니다.
1번과 2번은 짝으로 봐야 합니다. 표현을 바꿔도 답이 같으면 좋지만, 조건을 바꿔도 답이 같다면 그 응답자는 아무것도 판단하지 않는 것입니다. 일관성과 민감성을 함께 봐야 「같은 조건에서 같은 판단」을 확인할 수 있습니다.
특허 출원 내용
디지엠유닛원 주식회사는 위의 두 부분, 곧 목표 점수 없이 응답 일관성을 높이는 방법과 사람 조사와 비교해 검증·보정하는 절차를 담아 특허를 출원했습니다.
항목
내용
명칭
합성 페르소나의 응답 생성 장치 및 그의 동작 방법
출원일
2026년 10월 26일
출원번호
제10-2026-0207242호
청구항
16개
상태
특허 출원 단계로, 심사를 거쳐 등록 여부가 결정됩니다
일관성을 높이는 방법만이 아니라 사람 조사와 맞춰 보는 절차까지 함께 출원에 담은 데는 이유가 있습니다. 이 도구의 역할을 「사람 조사의 대체」가 아니라 「사람 조사를 언제, 누구에게 할지 정하는 일」로 보기 때문입니다. 출원 이후에도 실제 조사 데이터로 검증을 계속할 계획입니다.
이렇게 씁니다 — 실제 조사 전에 「무엇을, 누구에게」 정하는 도구
응답자 표본으로는 한국·미국·일본·인도·베트남·싱가포르·프랑스·벨기에·브라질·엘살바도르 10개국, 1,000만 건 규모의 가상 인물 데이터를 씁니다. NVIDIA가 나라별 인구통계 분포에 맞춰 만들어 공개한 합성 인구 데이터셋 Nemotron-Personas(한국 데이터셋 예)로, 실존 인물의 개인정보는 들어 있지 않습니다.
쓰는 흐름은 네 단계입니다.
응답자 그룹 구성 — 국가와 연령·성별·지역·직업 조건으로 가상 응답자 그룹을 만듭니다.
설문 실험 실행 — 제품 콘셉트 비교(A/B), 구매의향 조사, 가격 민감도 조사(PSM), 컨조인트 분석 가운데 필요한 실험을 진행합니다.
반응 비교 — 콘셉트·국가·소비자층별로 반응이 갈리는 지점을 확인합니다.
실제 조사 설계 — 반응이 갈린 콘셉트와 소비자층을 실제 조사의 대상으로 정합니다.
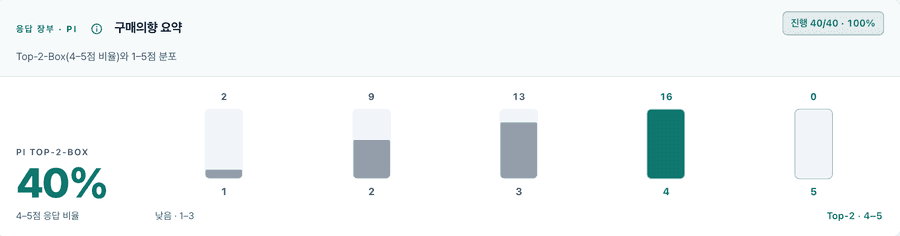
가상 콘셉트 1차안에 대한 한국 가상 응답자 40명의 구매의향 분포. (가상 콘셉트, 데모 데이터)
쓰임새는 독자마다 조금씩 다릅니다. 상품기획자라면 후보 콘셉트 가운데 실제 조사에 올릴 것을 고르는 데, 해외 시장을 보는 마케터라면 어느 나라에서 현지 조사를 할지 정하는 데, 연구자라면 본 조사 전에 문항과 실험 조건을 미리 걸러 보는 파일럿에 쓸 수 있습니다. 실제 데모 흐름은 콘셉트 테스트 4단계 글에서 화면과 함께 따라가 볼 수 있습니다.
이 방식의 한계
사람 조사를 대신하지 않습니다. 가상 응답자의 결과는 실제 수요나 매출의 추정치가 아닙니다. 중요한 결정은 실제 사람 조사로 확인하시길 권합니다.
분포를 반영한 데이터라도 개인의 실제 의견은 아닙니다. 합성 인구 데이터는 인구통계 분포를 따를 뿐, 특정 개인의 생각을 담고 있지 않습니다.
일관성은 출발점입니다. 일관된 답이 곧 정확한 답은 아니므로, 사람 조사와 맞춰 보는 단계가 함께 있어야 합니다.
논문용 설문 실험이나 파일럿 조사를 준비하는 연구자라면 연구 목적 활용 문의로 연락해 주세요.
참고 문헌
Argyle, L. P., Busby, E. C., Fulda, N., Gubler, J. R., Rytting, C., & Wingate, D. (2023). Out of one, many: Using language models to simulate human samples. Political Analysis, 31(3), 337–351. doi:10.1017/pan.2023.2
Tjuatja, L., Chen, V., Wu, S. T., Talwalkar, A., & Neubig, G. (2024). Do LLMs exhibit human-like response biases? A case study in survey design. Transactions of the Association for Computational Linguistics, 12, 1011–1026. doi:10.1162/tacl_a_00685
Dominguez-Olmedo, R., Hardt, M., & Mendler-Dünner, C. (2024). Questioning the survey responses of large language models. Advances in Neural Information Processing Systems 37 (NeurIPS 2024), 45850–45878. doi:10.52202/079017-1458
가상 인물 데이터의 출처는 NVIDIA Nemotron-Personas(CC BY 4.0)입니다.
NEXT STEP
우리 제품 콘셉트로 직접 해 보고 싶다면
담당자가 귀사의 제품·대상 시장에 맞춘 데모 실험을 함께 설계해 드립니다. 실제 조사 전에 무엇을, 누구에게 물을지 먼저 확인해 보세요.